 Documentation
Concept de réplication de base de données
Architecture
Le SKOOR Engine utilise une base de données PostgreSQL pour stocker ses données de configuration ainsi que ses valeurs historiques et ses données d'historique. Il prend en charge l'utilisation d'une configuration primary/standby pour répliquer en continu le contenu de la base de données. Les propres méthodes de réplication de PostgreSQL sont utilisées, ce qui signifie qu'une copie exacte de la base de données du primary est conservée sur le standby et que toutes les mises à jour de la base de données sur le server primary sont immédiatement répliquées sur le standby. Le server primary met en mémoire tampon les instructions SQL dans un journal binaire, et le server standby demande ces instructions au server.
Cela garantit des temps d'indisponibilité courts en cas de panne matérielle. Toutefois, cela ne protège PAS contre les erreurs de manipulation, telles que des instructions de suppression erronées qui seront immédiatement synchronisées sur le standby. La réplication ne remplace pas les sauvegardes régulières.
La figure suivante montre un exemple d'architecture de réplication standard.
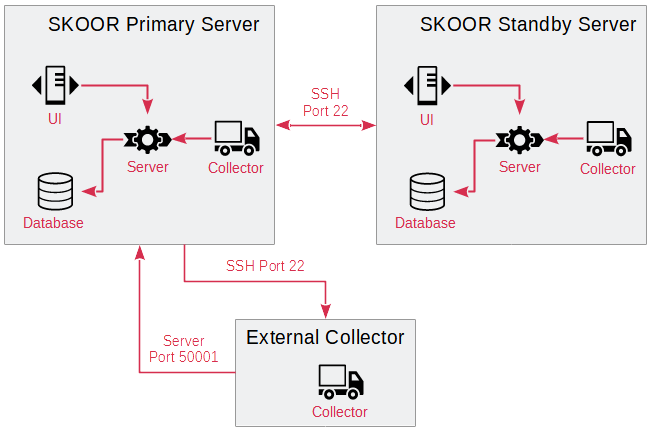
En mode par défaut, le primary supporte toute la charge, toutes les requêtes des utilisateurs sont traitées par le serveur web Apache sur le primary, les données de mesure sont transmises par les collecteurs au server primary actuel et stockées dans la base de données. Les services eranger-server, eranger-collector et eranger-report ne s'exécutent PAS sur le server standby.
Principales fonctionnalités de la configuration de réplication
La réplication peut être mise en œuvre même avec des collecteurs SKOOR externes.
Si une réplication a déjà été effectuée précédemment, une grande partie des fichiers de la base de données sera probablement déjà synchronisée. Le script ne transférera PAS les anciennes tables qui sont déjà synchronisées. Cela économise la bande passante réseau si une réinitialisation doit être lancée.
Il n'y a pas de basculement automatique du primary vers le standby. Le système a été conçu pour laisser cette décision à un opérateur humain. Toutefois, le script prend en charge un mode non interactif permettant de déclencher un basculement par script (option -f).
Possibilité de surveiller le primary depuis le standby (indépendamment de SKOOR) en envoyant un e-mail dès qu'il détecte que le SKOOR Engine ne fonctionne plus sur le primary actuel.
Possibilité d'exécuter des scripts ou commandes personnalisés avant et/ou après le basculement des fonctions du server (de standby à primary et vice versa).
Prérequis
Pour configurer la réplication de la base de données, un second SKOOR Server doté des mêmes spécifications de performance que le premier est requis. Bien que ce standby reste en mode veille la plupart du temps, il doit être capable de supporter toute la charge lorsque sa fonction passe de standby à primary.
Les prérequis suivants doivent être remplis :
La même version de SKOOR est installée sur le primary et le standby.
(Facultatif) les collecteurs externes sont correctement configurés et fonctionnent
Le paramètre server<n>_address doit être défini sur la même adresse IP que le server primary
Les collecteurs utilisant le protocole HTTP ne peuvent pas être basculés automatiquement
Le fichier /opt/eranger/bin/eranger-server-replication.pl est identique sur le primary, le standby et tous les collecteurs. Cela signifie que tous les hôtes concernés doivent disposer de la même version de SKOOR.
Le fichier /etc/opt/eranger/eranger-replication.cfg est correctement configuré et est identique sur le primary, le standby et tous les collecteurs.
Connectivité réseau
Port TCP 22 (ssh) du primary vers le standby, inversement, ainsi que du primary et du standby vers tous les collecteurs externes.
Port TCP 50001 (transmission des données du collecteur SKOOR) de tous les collecteurs externes vers le primary et le standby.