Documentation
Parsefile
Fonction | Analyser un fichier pour en extraire du texte et/ou des valeurs, calculer des valeurs différentielles. Jusqu'à 32 valeurs / valeurs de chaîne / valeurs différentielles / valeurs de taux / résultats de comparaison / compteurs de correspondances et événements sont possibles par job d'analyse |
|---|---|
Alarmes | Correspondances de chaînes, Comptages de chaînes, Valeurs, Valeurs de chaîne, Valeurs différentielles, Valeurs de taux, Événements, Âge du fichier, Âge du contenu du fichier, Code de réponse Particularité : le job peut passer à l'état Maintenance OK ou Maintenance Major, selon les limites d'alarme configurées. |
Détails de Parsefile
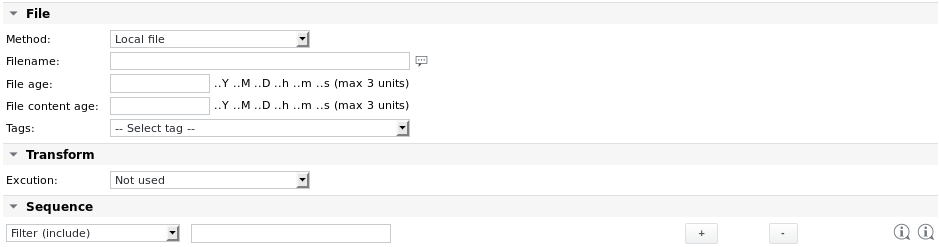
Paramètres Parsefile
Paramètre | Description |
|---|---|
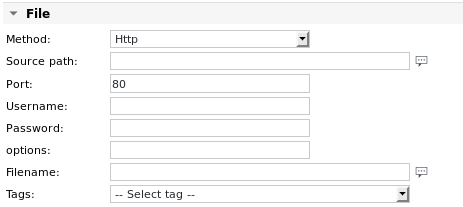
Method | Le fichier à analyser peut être soit un Local file (par défaut), soit être récupéré au préalable à l'aide de l'un des protocoles suivants : HTTP Si l'un des protocoles distants est choisi, des paramètres supplémentaires s'affichent pour le chemin source et l'authentification de l'utilisateur. Voir le job Fetchfile pour plus de détails sur la configuration. Exemple : récupérer d'abord le fichier depuis un serveur web avant de l'analyser : La récupération d'un fichier distant directement depuis le job Parsefile est la méthode recommandée. Une alternative consiste à créer un job Batch contenant un job Fetchfile ou Agent Fetchfile et un job Parsefile. Si le système distant fonctionne sous Windows et que le WinAgent SKOOR est installé, les fichiers peuvent également être récupérés à l'aide du WinAgent. WinAgent apparaît dans la liste déroulante des méthodes dès que les propriétés Agent username et Agent password sont définies sur le périphérique du job. Sous Windows 10, OpenSSH server peut être installé depuis les fonctionnalités facultatives. Après avoir démarré le service correspondant, les fichiers peuvent être copiés à l'aide de scp. |
Filename | Le nom du fichier à analyser. Le chemin peut être spécifié de manière relative par rapport au répertoire d'analyse par défaut sur le collecteur (défini dans le fichier /etc/opt/eranger/eranger-collector.cfg, normalement défini sur /var/opt/run/eranger/collector/tmp) ou de manière absolue. Si le fichier se trouve dans un sous-répertoire du répertoire par défaut configuré, le nom du fichier peut être saisi sous la forme : subdir/file.txt |
File age | Teste la date et l'heure du dernier accès au fichier. S'il est plus ancien que la valeur indiquée, le job émet un avertissement (File too old). File age peut être saisi en minutes ou en secondes ; les formats tels que « 1h 30m » sont également pris en charge. |
File content age | Teste si le contenu du fichier a changé. S'il n'a pas changé pendant la durée saisie ici, le job émet un avertissement (File content too old). Le format de File content age est le même que pour le paramètre File age. |
Transform → Execution | Si la transformation automatique fournie par le job n'est pas suffisante pour une raison quelconque, le fichier peut être prétraité par l'une des options suivantes avant d'être analysé : Not used (Aucun prétraitement) |
Sequence | Voir la section suivante |
La liste déroulante Tags permet de saisir des variables prédéfinies dans les champs ci-dessus, par exemple $NAME$ pour le nom du job.
Transformations de fichiers standard
Si un fichier a été récupéré depuis un système autre que Linux, certains caractères spéciaux doivent être adaptés pour l'analyse. La liste suivante indique les cas gérés automatiquement par le job :
Les caractères de retour chariot Windows sont supprimés (auparavant effectué par l'option de transformation dos2unix)
Si le fichier est encodé en UTF-8 avec BOM (Byte Order Mark), le BOM est supprimé
Si le fichier est encodé en Unicode (UTF-16 big-endian ou UTF-16 little-endian)
Si aucune transformation n'est définie, le fichier est converti en UTF-8 avant l'analyse
Si une transformation est définie, aucune modification n'est apportée au fichier (on suppose que la transformation traite correctement le fichier)
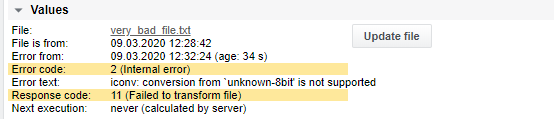
En cas d'échec de la transformation, les codes Response et Error du job afficheront les messages suivants :
Le Response code 11 (Failed to transform file) sera toujours affiché et doit être configuré comme limite d'alarme
L'Error code 1 (System error) ou 2 (Internal error) peut être affiché en plus
Séquence Parsefile
Comportement général
Si le fichier est introuvable, le code de réponse est défini sur 1 (File not found) et l'exécution est interrompue.
Si File age et/ou File content age est défini, ces vérifications sont effectuées avant l'analyse du fichier.
Si le fichier est trop ancien, le code de réponse est défini sur 2 (File too old), mais le fichier est tout de même analysé.
Si le contenu du fichier est trop ancien, le code de réponse est défini sur 3 (File content too old), mais le fichier est tout de même analysé.
Si un fichier contient plus de 100000 lignes, le code de réponse est défini sur 4 (File too long) et l'exécution est interrompue. La limite par défaut peut être augmentée ou supprimée en ajoutant la ligne suivante dans le fichier de configuration de SKOOR Engine /opt/eranger/etc/eranger-collector.cfg :
parsefile_line_limit = 1000000                     raise limit to a million lines
parsefile_line_limit = 0                           remove limit altogether
Lors de l'ajout de nouvelles valeurs, valeurs de chaîne, valeurs différentielles, etc., un maximum de 32 entrées est possible dans la séquence d'analyse pour chaque type de valeur. Par exemple, lors de l'ajout de 3 valeurs à l'aide de l'élément Get value, commencez par ajouter Get value avec l'index 1, puis 2, puis 3, en augmentant le numéro d'index. L'interface utilisateur ne permet de sélectionner qu'un index maximal basé sur le nombre d'éléments de séquence actuellement configurés afin que la liste déroulante de sélection d'index ne prenne pas trop de place.
Éléments disponibles dans la liste déroulante des filtres de séquence
Set
Filter (include)
Toutes les lignes du fichier qui ne contiennent pas l'expression sont ignorées ; par exemple, saisir « localhost » (sans guillemets) ne prendra en compte que les lignes contenant « localhost » ; les autres lignes sont ignorées.
Filter (exclude)
Cela fonctionne dans le sens inverse, c'est-à-dire comme un filtre négatif.
Toutes les lignes contenant l'expression sont ignorées pour l'analyse du reste de la séquence.
Define delimiter
Le délimiteur de colonne par défaut est l'espace blanc (1 espace, plusieurs espaces consécutifs, tabulations). Cela divise effectivement les lignes en mots.
Un autre délimiteur peut être choisi ici. Saisissez une chaîne d'un ou plusieurs caractères comme « ; » ou « COL ». Au cours d'une séquence, le délimiteur peut être défini et réinitialisé plusieurs fois. Pour le réinitialiser, laissez le champ de texte vide.
La numérotation des colonnes commence à 0 (zéro).
Syslog mode
Si cette option est activée, l'analyse reprend à la première nouvelle ligne ajoutée dans le fichier depuis la dernière exécution du job.
Si le fichier a fait l'objet d'une rotation, le fichier archivé est utilisé à partir de la dernière position EOF afin qu'aucune donnée ne soit perdue.
Ignore case
Si cette option est activée, la casse est ignorée pour les comparaisons de chaînes.
Ignore not found
Si une ligne, une expression ou une colonne est introuvable, le code de réponse n'est pas défini sur 7 String not found, mais l'exécution du job est interrompue.
Continue after not found
Si cette option est activée, l'analyse se poursuit lorsqu'une ligne ou une colonne n'a pas été trouvée.
Detect overflow on/off
Si cette option est activée, tous les paramètres Diff value suivants dans la séquence ignoreront les valeurs inférieures à la valeur mesurée lors de l'exécution précédente du job (seules les différences positives sont autorisées).
Cela est principalement utilisé pour les compteurs. Le paramètre peut être désactivé plus tard dans la séquence.
Get timestamp (rate)
Un horodatage peut être lu depuis un fichier pour des calculs exacts à l'aide du paramètre de séquence Get rate value. Par exemple, si le fichier analysé est généré par une application exécutée de manière asynchrone.
L'horodatage dans le fichier doit être exprimé en secondes, en ms ou en µs.
Find
Les paramètres suivants font référence aux lignes. La portée du paramètre suivant est la ligne trouvée par le paramètre actuel. Si une ligne demandée n'existe pas, le code de réponse est défini sur 5 (Line not found) et l'exécution est interrompue, sauf si Continue after not found est activé.Go to line #
Le pointeur d'analyse est positionné au début de la ligne correspondante.
Go to next line
Le pointeur d'analyse est positionné au début de la ligne suivante.
Go to first line with
Le pointeur d'analyse est positionné au début de la première ligne qui correspond à la chaîne/expression.
Si aucune ligne contenant une telle expression n'est trouvée et que « Continue after not found » est activé, le pointeur d'analyse est positionné sur le premier caractère de la première ligne du fichier et le reste de la séquence est traité.
Go to next line with
Le pointeur d'analyse est positionné au début de la ligne suivante qui correspond à la chaîne/expression.
Si aucune ligne contenant une telle expression n'est trouvée et que « Continue after not found » est activé, le pointeur d'analyse est positionné sur le premier caractère de la ligne suivante et le reste de la séquence est traité.
Go to last line with
Le pointeur d'analyse est positionné au début de la dernière ligne qui correspond à la chaîne/expression.
Si aucune ligne contenant une telle expression n'est trouvée et que « Continue after not found » est activé, le pointeur d'analyse est positionné sur le premier caractère de la première ligne du fichier et le reste de la séquence est traité.
Find delimiter based
Les commandes suivantes dépendent de la définition d'un délimiteur. Si aucun délimiteur n'est défini, l'espace blanc (espaces ou tabulations) est utilisé comme délimiteurGo to column #
Le pointeur d'analyse est positionné sur le premier caractère de la colonne correspondante (0..n) de la ligne actuelle.
Si la colonne est introuvable, le code de réponse est défini sur 6 (Column not found) et l'exécution est interrompue.
Si la colonne est introuvable et que Continue after not found est activé, la position du pointeur d'analyse n'est pas modifiée.
La portée des commandes de chaîne suivantes correspond par défaut à l'ensemble du fichier ; si l'une des commandes de ligne a été appelée précédemment, la portée est la ligne actuelle.
Si le champ est laissé vide, le code d'erreur est défini sur 7 (Invalid parameter) et l'exécution est interrompue.
Go to first string
Selon la portée, la première occurrence de la chaîne dans l'ensemble du fichier / dans la ligne actuelle qui correspond à l'expression est recherchée.
Si elle est trouvée, le pointeur d'analyse est positionné sur le premier caractère qui correspond à l'expression, puis incrémenté de la longueur de l'expression
Sinon, l'exécution est interrompue et le code de réponse est défini sur 7 (String not found), sauf si Ignore not found ou Continue after not found a été activé ci-dessus.
Go to next string
Identique à ci-dessus, mais la recherche commence à la position actuelle afin que l'analyseur recherche l'occurrence suivante.
Go to last string
Identique à ci-dessus, mais l'analyseur recherche la dernière occurrence d'une expression.
Les paramètres suivants prennent en charge la gestion des événements conformément au job Agent Eventlog et peuvent suivre jusqu'à 4 événements.
Event
Set eventX
Un événement est défini lorsqu'une ligne correspond à une expression ou une chaîne donnée.
Jusqu'à 32 événements peuvent être configurés et définis.
Reset eventX
Un événement est réinitialisé lorsqu'une ligne suivante correspond à une expression donnée.
Jusqu'à 32 réinitialisations d'événements peuvent être configurées et définies.
Reset eventX after
Un événement est réinitialisé après un délai d'expiration donné (par exemple 10m = 10 minutes).
Jusqu'à 32 délais d'expiration peuvent être configurés et définis.
La condition de réinitialisation n'est évaluée qu'au moment de l'exécution du job. Si un événement a été défini et qu'aucune nouvelle chaîne correspondante n'est trouvée lors de l'exécution suivante du job, l'événement sera réinitialisé si le délai d'expiration ci-dessus est atteint.
Values
Get valueX
À partir de la position actuelle, une valeur numérique est recherchée et affectée si elle est trouvée
Sinon, le code de réponse est défini sur 8 (Value not found) et l'exécution est interrompue.
Le pointeur d'analyse est positionné sur le premier caractère suivant la valeur trouvée.
Cliquer sur le bouton Unit ouvre la boîte de dialogue suivante :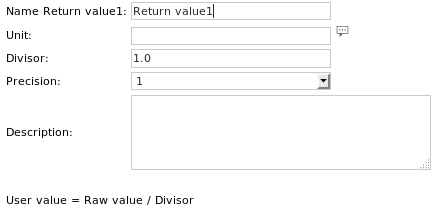
Il est possible d'y spécifierle nom de la valeur à renvoyer (facultatif)
son unité (par exemple secondes, facultatif)
un diviseur par lequel la valeur doit être divisée (facultatif)
la précision numérique en sortie (par exemple 1.000)
Get diff valueX
À partir de la position actuelle, une valeur numérique est recherchée et la différence par rapport à la valeur trouvée lors de la dernière exécution est affectée.
Le pointeur d'analyse est positionné sur le premier caractère suivant la valeur trouvée.
Get rate valueX
La valeur de taux représente la différence entre la valeur actuelle et la dernière valeur, divisée par le temps (en secondes) écoulé entre les deux mesures :
(Valnow - Vallast) / (tnow - tlast)
Habituellement, l'horodatage de l'exécution du job est utilisé pour ce calcul. Il peut toutefois également être lu depuis le fichier à l'aide de l'élément Get timestamp (rate) (voir ci-dessus)
Si la différence d'horodatage est <= 0, aucune nouvelle valeur de taux n'est générée.
Get string valueX
Cela permet de récupérer une valeur de chaîne depuis un fichier. N'utilisez cette option que pour des chaînes qui ne changent pas souvent, c'est-à-dire lorsque la chaîne fait partie d'un petit ensemble de chaînes connues dans le texte analysé.
La chaîne peut être mappée à une valeur numérique à l'aide des champs de configuration accessibles en cliquant sur le bouton Unit.
Compare stringX
L'expression (qui peut être une simple chaîne ou une expression régulière) est évaluée et la valeur 1 (Found) ou 0 (Not Found) est affectée comme valeur de retour.
Le nom de la valeur de retour ci-dessus et le texte affiché à côté de la valeur de retour peuvent être personnalisés en cliquant sur le bouton Enum à droite de ce paramètre. Cela ouvre la boîte de dialogue suivante :
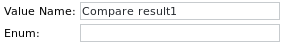
ce qui affichera les éléments suivants pour une comparaison réussie dans la section Values :
Check status: 1 (Status is OK)
au lieu de l'affichage par défaut :
Compare result1: 1 (Found)
Cela permet d'associer la valeur de retour à un message spécifique.Les caractères spéciaux ^ ou $ peuvent être utilisés pour rechercher des expressions au début ou à la fin d'une ligne. Par exemple, saisir « ^AAA » (sans guillemets) renverra Found si la chaîne « AAA » se trouve au début de la ligne, mais renverra Not found si la ligne la contient tout en commençant par autre chose que « AAA ». De même, saisir « AAA$ » ne trouvera la chaîne que si elle se trouve à la fin de la ligne.
Si un ensemble de combinaisons chaîne/valeur au format « 1=AAA, 2=BBB » ou « 1=AAA,2=BBB,0=* » est saisi et qu'une chaîne de l'ensemble est trouvée après la position actuelle sur la ligne actuelle, le numéro approprié est affecté comme valeur de sortie (le second exemple renvoie 0 pour les chaînes ne figurant pas dans l'ensemble). Cela permet d'obtenir plus de valeurs de retour que les valeurs par défaut 0 ou 1. De plus, ces valeurs de retour peuvent ensuite être associées à des messages de sortie à l'aide du champ Enum.
Les caractères spéciaux qui font généralement partie d'une expression régulière, par exemple « ( », doivent être échappés avec une barre oblique inverse (backslash) pour être reconnus correctement.
Le pointeur d'analyse est positionné sur le premier caractère après l'expression évaluée qui n'est ni un espace, ni une tabulation, ni une barre verticale (| ou ¦), ou à la colonne suivante si un délimiteur a été défini.
Count string matchesX
Si un paramètre de ligne a été utilisé plus haut dans la séquence, toutes les occurrences d'une chaîne sur la ligne actuelle sont comptées ; sinon, toutes les occurrences de la chaîne dans l'ensemble du fichier sont comptées.
Le pointeur d'analyse n'est pas déplacé.
Text to info message
Le texte compris entre la position actuelle du pointeur d'analyse et la fin de la ligne est copié dans le message d'information. S'il n'y a pas de texte, le code de réponse est défini sur 9 (Text for Info not found) et l'exécution est interrompue.
Le pointeur d'analyse n'est pas déplacé.
Valeurs et limites d'alarme de Parsefile
Le job Parsefile peut passer aux états de maintenance Maintenance OK ou Maintenance Major, selon les autres limites d'alarme configurées. Par exemple, si la limite d'alarme suivante est configurée :
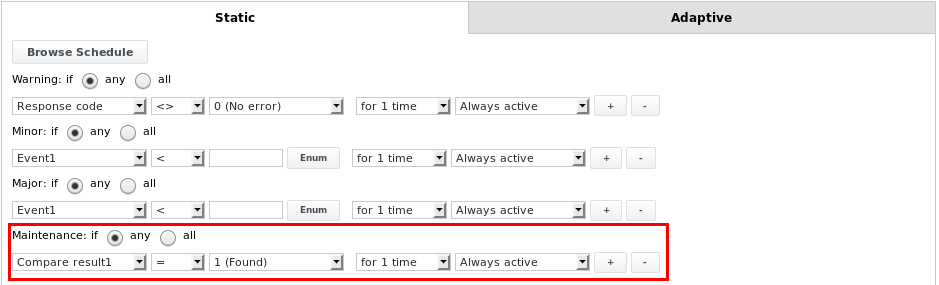
Le job passera à l'état Maintenance OK si la comparaison de texte correspond à une certaine chaîne ou expression et s'il est par ailleurs à l'état OK. Cela peut être utilisé pour placer le job et son périphérique parent (la maintenance est propagée vers le haut, d'un job vers son périphérique) en mode maintenance selon ce qui est trouvé lors de l'analyse d'un fichier contenant des informations sur l'état de maintenance, par exemple provenant d'autres systèmes de surveillance comme Nagios. Toutes les autres limites d'alarme ci-dessous peuvent également être utilisées dans la limite d'alarme Maintenance.
Valeur / Limite d'alarme | Description |
|---|---|
Event1-X | Vérifie si un événement a été déclenché sur la base du paramètre de séquence Set Event ci-dessus. |
Return value1-X | Valeur numérique définie par l'utilisateur sur la base du paramètre de séquence Get value ci-dessus. |
Rate value1-X | Valeur numérique de taux définie par l'utilisateur sur la base du paramètre de séquence Get rate value ci-dessus. |
Diff value1-X | Valeur numérique différentielle définie par l'utilisateur sur la base du paramètre de séquence Get diff value ci-dessus. |
String value1-X | Valeur de chaîne définie par l'utilisateur sur la base du paramètre de séquence Get string value ci-dessus. |
Compare result1-X | Valeur définie par l'utilisateur sur la base du paramètre de séquence Compare string value ci-dessus. |
Match counter1-X | Valeur définie par l'utilisateur sur la base du paramètre de séquence Count string matches ci-dessus. |
Response code | 0 No error |
Error code | Code d'erreur générique du job (voir la section Job error codes) |
Exemples Parsefile
Exemple 1 - Analyser un fichier file.txt ayant le contenu suivant afin de lire les 3 valeurs des 3 dernières lignes :
11;OK;33;44.9888;MK;Duration (average): 203.6533s
Open cases:
10
8
1
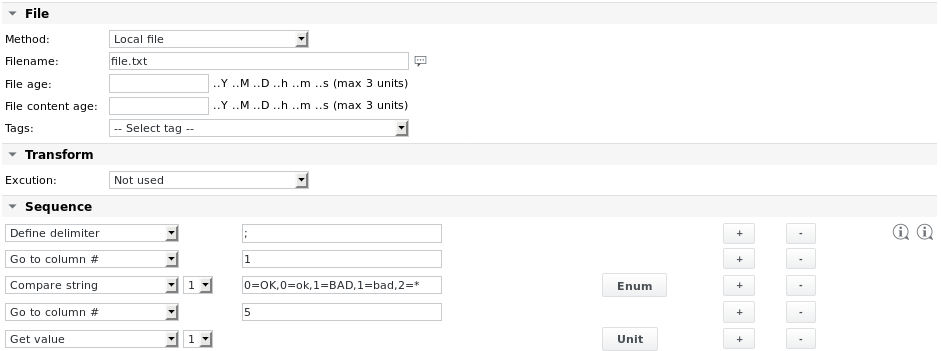
La configuration du job se présente comme suit :
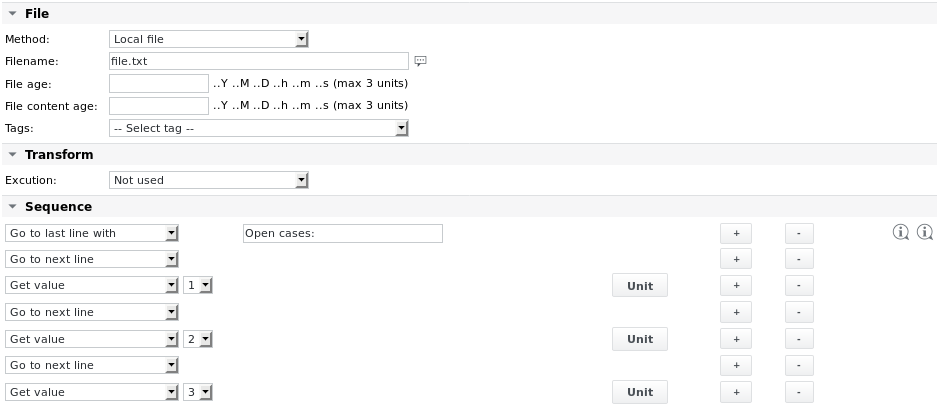
La définition Unit du premier élément Get value est :
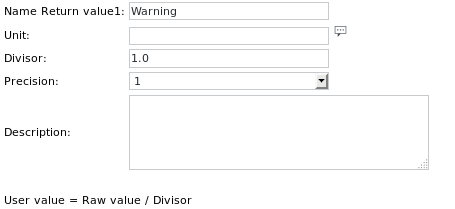
Les 2 autres définitions Unit sont similaires, avec respectivement les noms Minor et Major.
Sortie 1
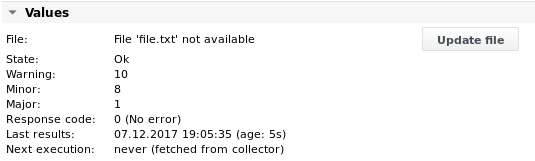
Exemple 2 - Analyser le même fichier file.txt et extraire des valeurs de sa première ligne en fonction des colonnes
La définition Enum de l'élément Compare string 1 est la suivante :
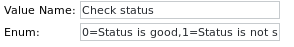
Texte complet : 0=Status is good,1=Status is not so good,2=Status is unknown
La définition Unit pour Get value 1 est la suivante :
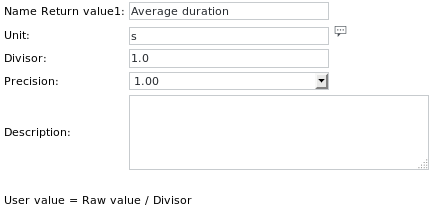
Notez la valeur accrue de Precision, permettant de lire des valeurs numériques à virgule flottante.
Sortie 2
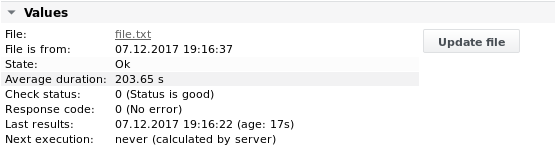
Exemple 3 - Rechercher une ligne contenant le nom du server à l'aide de balises variables. Rester sur cette ligne et récupérer les valeurs MeasurementValue1 et CPU_Usage
Le contenu du fichier est le suivant :
Timestamp=Fri Oct 31 09:55:20 CET 2017
ServerName=myserver01;MeasurementValue1=1.11;CPU_Usage=10%;EnumValue1=OK;
ServerName=myserver02;MeasurementValue1=1.22;CPU_Usage=22%;EnumValue1=BAD;
Le nom du périphérique est myserver01.
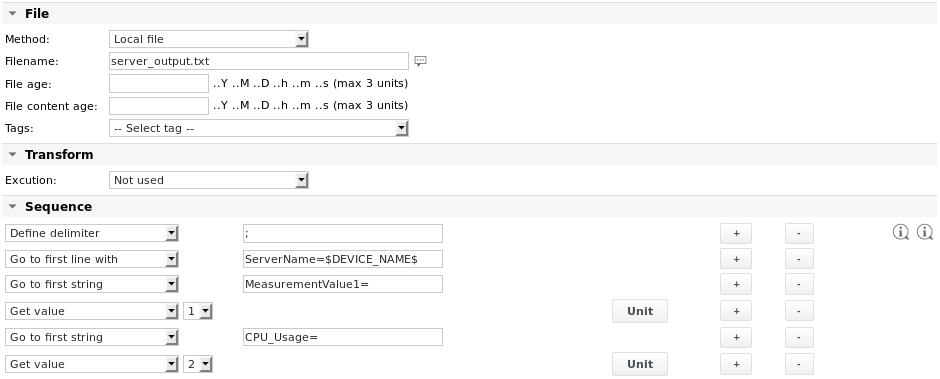
Les définitions Unit sont les suivantes :
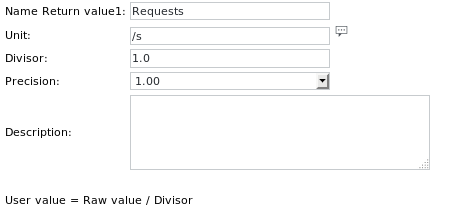
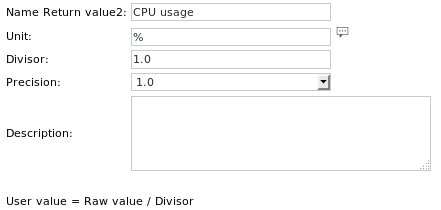
L'utilisation des balises SKOOR Engine permet de copier des jobs vers différents périphériques tout en conservant leur bon fonctionnement avec le nom de périphérique correct.
Sortie 3
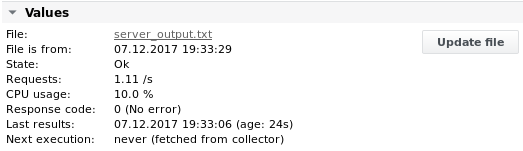
Exemple 4 - Lire un horodatage à partir d'un fichier généré régulièrement et lire une valeur de taux pour obtenir le nombre de paquets entrants et sortants sur une interface réseau
Le fichier est généré régulièrement avec le contenu suivant à partir d'un job Execute contenant l'Inline script suivant :
date +%s%N | cut -c1-13
netstat -I=eth0
La première ligne affiche l'horodatage (secondes depuis le 1.1.1970) avec une précision en millisecondes, et la deuxième ligne affiche les statistiques de réception/transmission sur l'interface réseau eth0. Le fichier généré est :
1512726065120
Kernel Interface table
Iface       MTU Met    RX-OK RX-ERR RX-DRP RX-OVR    TX-OK TX-ERR TX-DRP TX-OVR Flg
eth0       1500   0  5761332      0      0      0  2932100      0      0      0 BMRU
Les valeurs de taux (paquets entrants et sortants) sont indépendantes des intervalles d'exécution du job Execute et du job Parsefile. Habituellement, on place le job Execute et le job Parsefile sous un job Batch en leur attribuant un intervalle d'exécution No repetition, seul le job Batch disposant alors d'un intervalle d'exécution.
Le job Parsefile se présente comme suit :
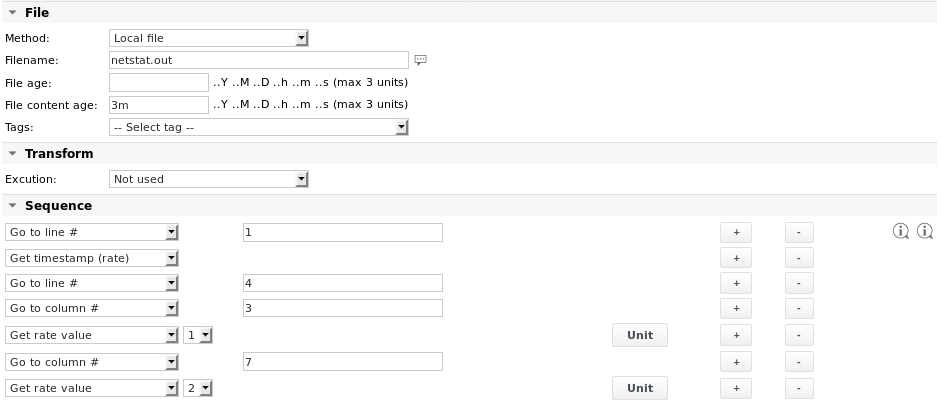
Les définitions Unit sont les suivantes :
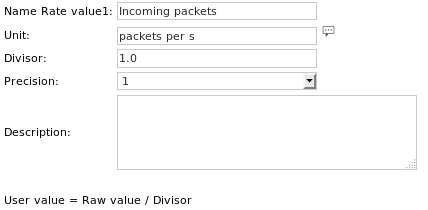
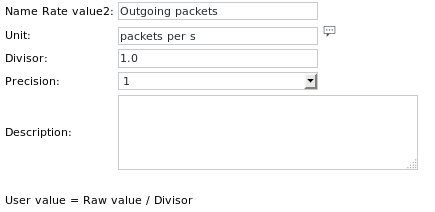
Sortie 4
Les valeurs sont affichées après la deuxième exécution du job (la valeur de taux nécessite une comparaison avec la mesure précédente) :
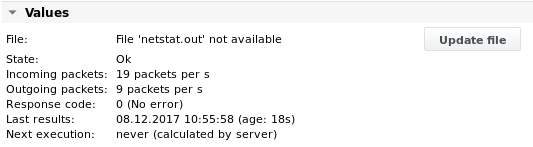
Exemple 5 - Générer des événements à partir du contenu analysé
Lire un fichier généré par un job externe et rechercher certaines chaînes. Générer un event1 lorsque la chaîne Error est trouvée. Réinitialiser l'événement après un certain temps. Générer également un event2 si la chaîne Process mysqld terminated est trouvée. Ne réinitialiser le deuxième événement que si la chaîne Process mysqld started est trouvée plus loin dans le fichier ou lors de l'exécution suivante du job.
Dans cet exemple, le premier élément de la séquence d'analyse définit le paramètre Syslog mode. Cela garantit que seules les nouvelles données du fichier sont analysées. Les parties plus anciennes du fichier qui ont été analysées lors de la dernière exécution du job ne sont plus prises en compte pour les exécutions suivantes. Si la première exécution du job trouve la chaîne Error dans le fichier, elle définit Event1. Si aucune nouvelle chaîne Error n'est trouvée au cours des 10 exécutions suivantes du job (l'intervalle du job est défini sur 1 minute), l'événement est réinitialisé.
Le mécanisme d'événement permet au job de revenir à un état OK après un certain temps tout en conservant la possibilité de déclencher un e-mail d'alarme lorsqu'un événement est défini.
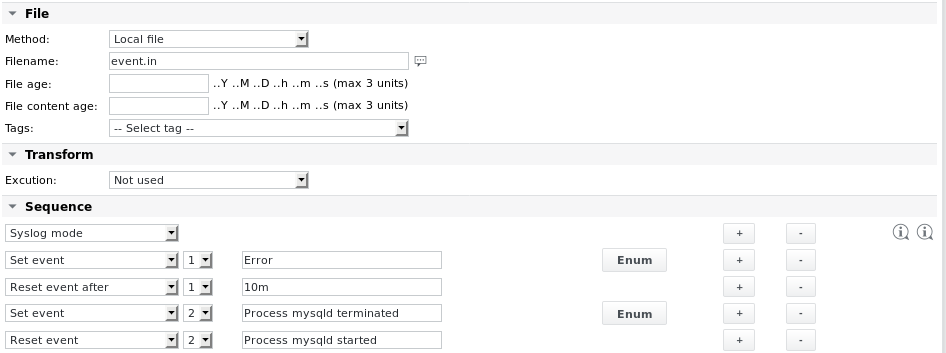
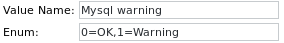
Les définitions Enum sont les suivantes :
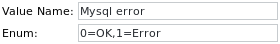
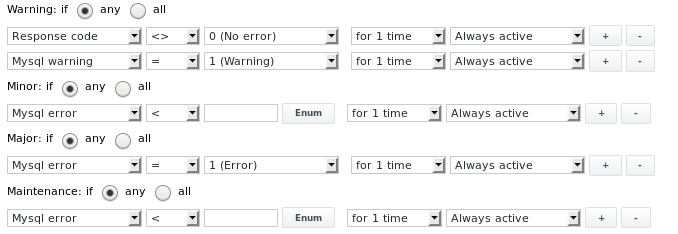
Les limites d'alarme sont configurées comme suit :
Sortie 5