Dokumentation
Parsefile
Funktion | Eine Datei nach Text und/oder Werten durchsuchen (parsen) und Differenzwerte bilden. Pro Parse-Job sind bis zu 32 Werte / String-Werte / Diff-Werte / Ratenwerte / Vergleichsergebnisse / Trefferzähler und Events möglich. |
|---|---|
Alarmierung | String-Treffer, String-Anzahl, Werte, String-Werte, Diff-Werte, Ratenwerte, Events, Dateialter, Alter des Dateiinhalts, Response-Code Besonderheit: Der Job kann basierend auf den konfigurierten Alarm Limits in den Zustand Maintenance OK oder Maintenance Major wechseln. |
Parsefile-Detail
Parsefile Parameter
Parameter | Beschreibung |
|---|---|
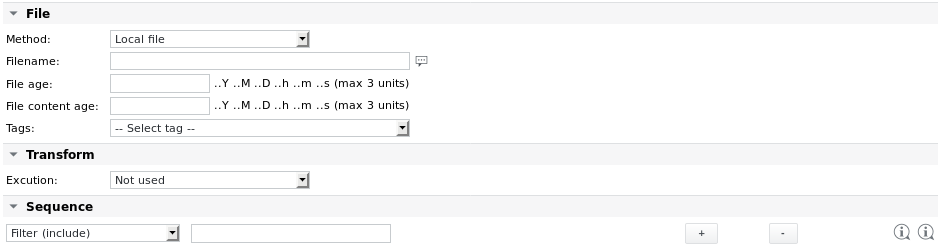
Method | Die zu parsende Datei kann entweder eine lokale Datei (Local file, Standard) sein oder zunächst über eines der folgenden Protokolle abgerufen werden: HTTP Wenn eines der Remote-Protokolle ausgewählt wird, werden zusätzliche Parameter für den Quellpfad und die Benutzerauthentifizierung angezeigt. Konfigurationsdetails finden Sie beim Job Fetchfile. Beispiel: Datei zuerst von einem Webserver abrufen, bevor sie geparst wird: Das Abrufen einer Remote-Datei direkt aus dem Parsefile-Job heraus ist die bevorzugte Methode. Eine Alternative wäre das Erstellen eines Batch-Jobs mit einem Fetchfile- oder Agent Fetchfile-Job und einem Parsefile-Job. Wenn auf dem Remote-System Windows ausgeführt wird und der SKOOR WinAgent installiert ist, können Dateien auch über den WinAgent abgerufen werden. WinAgent wird in der Dropdown-Liste „Method“ aufgeführt, sobald die Eigenschaften Agent username und Agent password auf dem Gerät des Jobs festgelegt sind. Unter Windows 10 kann der OpenSSH-Server über die optionalen Features installiert werden. Nach dem Starten des entsprechenden Dienstes können Dateien mit scp kopiert werden. |
Filename | Der Name der zu parsenden Datei. Der Pfad kann relativ zum Standard-Parse-Verzeichnis auf dem Kollektor (definiert in der Datei /etc/opt/eranger/eranger-collector.cfg, normalerweise auf /var/opt/run/eranger/collector/tmp gesetzt) oder absolut angegeben werden. Befindet sich die Datei in einem Unterverzeichnis des konfigurierten Standardverzeichnisses, kann der Dateiname wie folgt eingegeben werden: subdir/file.txt |
File age | Prüft Datum und Uhrzeit des letzten Zugriffs auf die Datei. Ist sie älter als der angegebene Wert, gibt der Job ein Warning (File too old) aus. File age kann in Minuten oder Sekunden eingegeben werden; Formate wie „1h 30m“ werden ebenfalls unterstützt. |
File content age | Prüft, ob sich der Dateiinhalt geändert hat. Hat er sich während der hier eingegebenen Zeit nicht geändert, gibt der Job ein Warning (File content too old) aus. Das Format für File content age entspricht dem des Parameters File age. |
Transform → Execution | Falls die vom Job bereitgestellte automatische Transformation aus irgendeinem Grund nicht ausreicht, kann die Datei vor dem Parsen mit einer der folgenden Optionen vorverarbeitet werden: Not used (Keine Vorverarbeitung) |
Sequence | Siehe nächster Abschnitt |
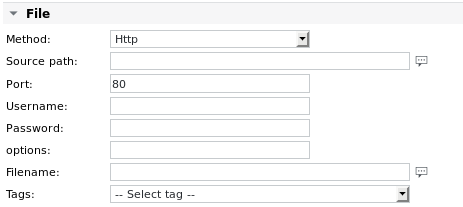
Über die Dropdown-Liste Tags können vordefinierte Variablen in die obigen Felder eingefügt werden, z. B. $NAME$ für den Namen des Jobs.
Standard-Dateitransformationen
Wenn eine Datei von einem anderen System als Linux abgerufen wurde, müssen einige Sonderzeichen für das Parsen angepasst werden. Die folgende Liste zeigt, welche Fälle vom Job automatisch behandelt werden:
Windows-Wagenrücklaufzeichen (Carriage Return) werden entfernt (früher durch die Transformationsoption Dos2unix durchgeführt)
Wenn die Datei in UTF-8 mit BOM (Byte Order Mark) kodiert ist, wird das BOM entfernt
Wenn die Datei in Unicode (Big-Endian UTF-16 oder Little-Endian UTF-16) kodiert ist
Wenn keine Transformation definiert ist, wird die Datei vor dem Parsen nach UTF-8 konvertiert
Wenn eine Transformation definiert ist, wird an der Datei nichts geändert (es wird angenommen, dass die Transformation die Datei korrekt verarbeitet)
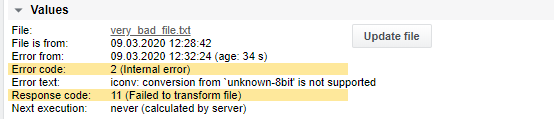
Falls die Transformation fehlschlägt, zeigen der Response-Code und der Error-Code des Jobs die folgenden Meldungen an:
Response-Code 11 (Failed to transform file) wird immer angezeigt und sollte als Alarm Limit konfiguriert werden
Error-Code 1 (System error) oder 2 (Internal error) kann zusätzlich angezeigt werden
Parsefile-Sequenz
Allgemeines Verhalten
Wird die Datei nicht gefunden, wird der Response-Code auf 1 (File not found) gesetzt und die Ausführung beendet.
Wenn File age und/oder File content age definiert ist, werden diese Prüfungen vor dem Parsen der Datei durchgeführt.
Ist die Datei zu alt, wird der Response-Code auf 2 (File too old) gesetzt; die Datei wird jedoch trotzdem geparst.
Ist der Dateiinhalt zu alt, wird der Response-Code auf 3 (File content too old) gesetzt; die Datei wird jedoch trotzdem geparst.
Enthält eine Datei mehr als 100000 Zeilen, wird der Response-Code auf 4 (File too long) gesetzt und die Ausführung beendet. Das Standardlimit kann erhöht oder entfernt werden, indem folgende Zeile in der SKOOR Engine-Konfigurationsdatei /opt/eranger/etc/eranger-collector.cfg hinzugefügt wird:
parsefile_line_limit = 1000000                     raise limit to a million lines
parsefile_line_limit = 0                           remove limit altogether
Beim Hinzufügen neuer Werte, String-Werte, Diff-Werte usw. sind innerhalb der Parse-Sequenz maximal 32 Einträge pro Werttyp möglich. Wenn Sie beispielsweise 3 Werte über das Element Get value hinzufügen, beginnen Sie mit dem Hinzufügen von Get value mit Index 1, dann 2, dann 3 mit aufsteigendem Indexzähler. Die Benutzeroberfläche erlaubt nur die Auswahl eines maximalen Index basierend auf der Anzahl der aktuell konfigurierten Sequenzelemente, damit die Dropdown-Liste zur Indexauswahl nicht zu viel Platz einnimmt.
Verfügbare Elemente in der Dropdown-Liste für Sequenzfilter
Set
Filter (include)
Alle Zeilen in der Datei, die den Ausdruck nicht enthalten, werden ignoriert. Die Eingabe von „localhost“ (ohne Anführungszeichen) berücksichtigt beispielsweise nur Zeilen, die „localhost“ enthalten; andere Zeilen werden übersprungen.
Filter (exclude)
Dies funktioniert umgekehrt, d. h. als Negativfilter.
Alle Zeilen, die den Ausdruck enthalten, werden beim Parsen der restlichen Sequenz ignoriert.
Define delimiter
Das Standard-Spaltentrennzeichen ist Leerraum (1 Leerzeichen, mehrere aufeinanderfolgende Leerzeichen, Tabulatoren). Dadurch werden Zeilen effektiv in Wörter unterteilt.
Hier kann ein anderes Trennzeichen gewählt werden. Geben Sie eine Zeichenfolge aus 1 oder mehr Zeichen wie „;“ oder „COL“ ein. Während einer Sequenz kann das Trennzeichen mehrmals gesetzt und zurückgesetzt werden. Lassen Sie das Textfeld zum Zurücksetzen leer.
Die Spaltenzählung beginnt bei 0 (Null).
Syslog mode
Wenn diese Option aktiviert ist, wird das Parsen bei der ersten neuen Zeile fortgesetzt, die seit der letzten Ausführung des Jobs zur Datei hinzugefügt wurde.
Wenn die Datei rotiert wurde, wird die rotierte Datei ab der letzten EOF-Position verwendet, sodass keine Daten verloren gehen.
Ignore case
Wenn diese Option aktiviert ist, wird bei String-Vergleichen die Groß-/Kleinschreibung ignoriert.
Ignore not found
Wenn eine Zeile, ein Ausdruck oder eine Spalte nicht gefunden wird, wird der Response-Code nicht auf 7 String not found gesetzt, die Job-Ausführung wird jedoch beendet.
Continue after not found
Wenn diese Option aktiviert ist, wird das Parsen fortgesetzt, nachdem eine Zeile oder Spalte nicht gefunden wurde.
Detect overflow on/off
Wenn diese Option aktiviert ist, ignorieren alle später in der Sequenz folgenden Diff value-Parameter Werte, die niedriger sind als der bei der vorherigen Job-Ausführung gemessene Wert (nur positive Differenzen zulässig).
Dies wird hauptsächlich für Zähler verwendet. Die Einstellung kann später in der Sequenz wieder ausgeschaltet werden.
Get timestamp (rate)
Für exakte Berechnungen mit dem Sequenzparameter Get rate value kann ein Zeitstempel aus einer Datei gelesen werden. Dies ist z. B. nützlich, wenn die geparste Datei von einer asynchron ausgeführten Anwendung erzeugt wird.
Der Zeitstempel in der Datei muss in den Einheiten Sekunden, ms oder µs angegeben sein.
Find
Die folgenden Parameter beziehen sich auf Zeilen. Der Geltungsbereich für den nächsten Parameter ist die vom aktuellen Parameter gefundene Zeile. Existiert eine gesuchte Zeile nicht, wird der Response-Code auf 5 (Line not found) gesetzt und die Ausführung beendet, außer wenn Continue after not found aktiviert ist.Go to line #
Der Parse-Zeiger wird am Anfang der entsprechenden Zeile positioniert.
Go to next line
Der Parse-Zeiger wird am Anfang der nächsten Zeile positioniert.
Go to first line with
Der Parse-Zeiger wird am Anfang der ersten Zeile positioniert, auf die der String/Ausdruck zutrifft.
Wenn keine Zeile mit einem solchen Ausdruck gefunden werden kann und „Continue after not found“ aktiviert ist, wird der Parse-Zeiger auf das erste Zeichen der ersten Zeile in der Datei positioniert und der Rest der Sequenz verarbeitet.
Go to next line with
Der Parse-Zeiger wird am Anfang der nächsten Zeile positioniert, auf die der String/Ausdruck zutrifft.
Wenn keine Zeile mit einem solchen Ausdruck gefunden werden kann und „Continue after not found“ aktiviert ist, wird der Parse-Zeiger auf das erste Zeichen der nächsten Zeile positioniert und der Rest der Sequenz verarbeitet.
Go to last line with
Der Parse-Zeiger wird am Anfang der letzten Zeile positioniert, auf die der String/Ausdruck zutrifft.
Wenn keine Zeile mit einem solchen Ausdruck gefunden werden kann und „Continue after not found“ aktiviert ist, wird der Parse-Zeiger auf das erste Zeichen der ersten Zeile in der Datei positioniert und der Rest der Sequenz verarbeitet.
Find delimiter based
Die folgenden Befehle hängen von der Definition eines Trennzeichens ab. Wenn kein Trennzeichen definiert ist, wird Leerraum (Leerzeichen oder Tabulatoren) als Trennzeichen verwendet.Go to column #
Der Parse-Zeiger wird auf das erste Zeichen der entsprechenden Spalte (0..n) in der aktuellen Zeile positioniert.
Wird die Spalte nicht gefunden, wird der Response-Code auf 6 (Column not found) gesetzt und die Ausführung beendet.
Wird die Spalte nicht gefunden und ist Continue after not found aktiviert, wird die Position des Parse-Zeigers nicht verändert.
Der Geltungsbereich der folgenden String-Befehle ist standardmäßig die gesamte Datei; wurde zuvor einer der Zeilenbefehle aufgerufen, ist der Geltungsbereich die aktuelle Zeile.
Wird das Feld leer gelassen, wird der Error-Code auf 7 (Invalid parameter) gesetzt und die Ausführung beendet.
Go to first string
Je nach Geltungsbereich wird nach dem ersten Vorkommen des Strings in der gesamten Datei bzw. in der aktuellen Zeile gesucht, auf den der Ausdruck zutrifft.
Bei einem Treffer wird der Parse-Zeiger auf das erste Zeichen positioniert, auf das der Ausdruck zutrifft, und anschließend um die Länge des Ausdrucks weitergesetzt.
Andernfalls wird die Ausführung beendet und der Response-Code auf 7 (String not found) gesetzt, außer wenn zuvor Ignore not found oder Continue after not found aktiviert wurde.
Go to next string
Wie oben, jedoch beginnt die Suche an der aktuellen Position, sodass der Parser nach dem nächsten Vorkommen sucht.
Go to last string
Wie oben, jedoch sucht der Parser nach dem letzten Vorkommen eines Ausdrucks.
Die folgenden Parameter unterstützen die Event-Behandlung entsprechend dem Job Agent Eventlog und können bis zu 4 Events verfolgen.
Event
Set eventX
Ein Event wird gesetzt, wenn eine Zeile einem angegebenen Ausdruck oder String entspricht.
Es können bis zu 32 Events konfiguriert und gesetzt werden.
Reset eventX
Ein Event wird zurückgesetzt, wenn eine nachfolgende Zeile einem angegebenen Ausdruck entspricht.
Es können bis zu 32 Reset-Events konfiguriert und gesetzt werden.
Reset eventX after
Ein Event wird nach einem angegebenen Timeout (z. B. 10m = 10 Minuten) zurückgesetzt.
Es können bis zu 32 Timeouts konfiguriert und gesetzt werden.
Die Rücksetzbedingung wird nur zur Job-Laufzeit ausgewertet. Wenn ein Event gesetzt wurde und bei der nächsten Job-Ausführung keine neuen entsprechenden Strings gefunden werden, wird das Event zurückgesetzt, sobald der obige Timeout erreicht ist.
Values
Get valueX
Beginnend an der aktuellen Position wird nach einem numerischen Wert gesucht und dieser bei einem Fund zugewiesen.
Andernfalls wird der Response-Code auf 8 (Value not found) gesetzt und die Ausführung beendet.
Der Parse-Zeiger wird auf das erste Zeichen nach dem gefundenen Wert gesetzt.
Durch Klicken auf die Schaltfläche Unit öffnet sich folgender Dialog: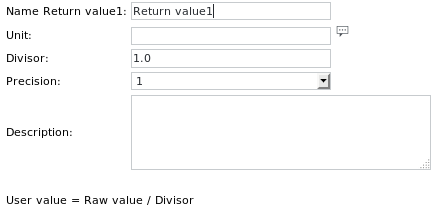
Hier können Sie Folgendes festlegen:den Namen des zurückzugebenden Werts (optional)
seine Einheit (z. B. Sekunden, optional)
einen Divisor, durch den der Wert geteilt werden soll (optional)
numerische Ausgabegenauigkeit (z. B. 1.000)
Get diff valueX
Beginnend an der aktuellen Position wird nach einem numerischen Wert gesucht und die Differenz zu dem bei der letzten Ausführung gefundenen Wert zugewiesen.
Der Parse-Zeiger wird auf das erste Zeichen nach dem gefundenen Wert gesetzt.
Get rate valueX
Der Ratenwert stellt die Differenz zwischen dem aktuellen Wert und dem letzten Wert geteilt durch die Zeitspanne (in Sekunden) dar, die zwischen den beiden Messungen vergangen ist:
(Valnow - Vallast) / (tnow - tlast)
Üblicherweise wird für diese Berechnung der Zeitstempel der Job-Ausführung verwendet. Er kann jedoch auch mithilfe des Elements Get timestamp (rate) aus der Datei gelesen werden (siehe oben).
Wenn die Zeitstempeldifferenz <= 0 ist, wird kein neuer Ratenwert generiert.
Get string valueX
Damit kann ein String-Wert aus einer Datei ausgelesen werden. Verwenden Sie dies nur für Strings, die sich nicht häufig ändern, d. h. wenn der String einer von wenigen bekannten Strings im geparsten Text ist.
Der String kann über die Konfigurationsfelder, die durch Klicken auf die Schaltfläche Unit zugänglich sind, einem numerischen Wert zugeordnet werden.
Compare stringX
Der Ausdruck (der ein einfacher String, aber auch ein regulärer Ausdruck sein kann) wird ausgewertet und entweder 1 (Found) oder 0 (Not Found) als Rückgabewert zugewiesen.
Der Name des obigen Rückgabewerts sowie der Text, der neben dem Rückgabewert angezeigt wird, können durch Klicken auf die Schaltfläche Enum rechts neben diesem Parameter beeinflusst werden. Dadurch öffnet sich folgender Dialog:
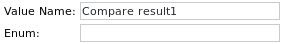
was bei einem erfolgreichen Vergleich im Bereich Values Folgendes anzeigt:
Check status: 1 (Status is OK)
anstelle des Standards:
Compare result1: 1 (Found)
Dadurch lässt sich der Rückgabewert einer bestimmten Meldung zuordnen.Die Sonderzeichen ^ oder $ können verwendet werden, um nach Ausdrücken am Zeilenanfang oder Zeilenende zu suchen. Beispielsweise gibt die Eingabe von „^AAA“ (ohne Anführungszeichen) Found zurück, wenn der String „AAA“ am Anfang der Zeile steht, jedoch Not found, wenn die Zeile diesen zwar enthält, aber mit etwas anderem als „AAA“ beginnt. Ebenso findet „AAA$“ den String nur, wenn er sich am Ende der Zeile befindet.
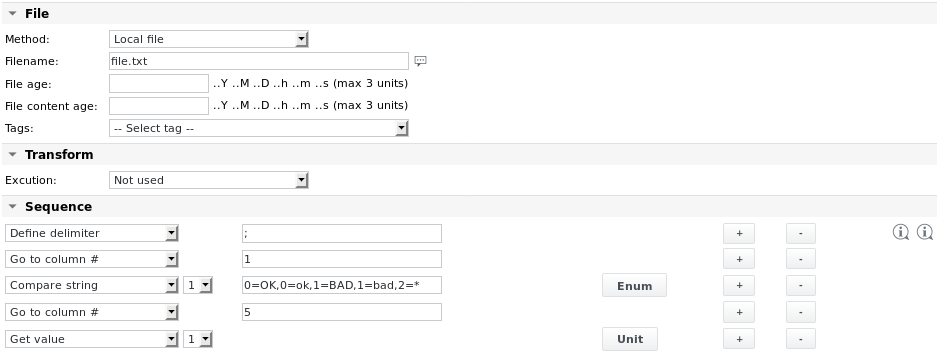
Wenn eine Reihe von String/Wert-Kombinationen im Format „1=AAA, 2=BBB“ oder „1=AAA,2=BBB,0=*“ eingegeben wird und ein String aus dieser Reihe nach der aktuellen Position in der aktuellen Zeile gefunden wird, wird die entsprechende Zahl als Ausgabewert zugewiesen (das zweite Beispiel gibt 0 für nicht in der Reihe enthaltene Strings zurück). Dies ermöglicht mehr Rückgabewerte als die Standardwerte 0 oder 1. Zusätzlich können diese Rückgabewerte mithilfe des Felds Enum weiteren Ausgabemeldungen zugeordnet werden.
Sonderzeichen, die normalerweise Teil eines regulären Ausdrucks sind, z. B. „(“, müssen mit einem Backslash maskiert (escaped) werden, um korrekt erkannt zu werden.
Der Parse-Zeiger wird auf das erste Zeichen nach dem ausgewerteten Ausdruck gesetzt, das kein Leerzeichen, Tabulator oder senkrechter Strich (| oder ¦) ist, oder auf die nächste Spalte, wenn ein Trennzeichen definiert wurde.
Count string matchesX
Wenn weiter oben in der Sequenz ein Zeilenparameter angegeben wurde, werden alle Vorkommen eines Strings in der aktuellen Zeile gezählt; andernfalls werden alle Vorkommen des Strings in der gesamten Datei gezählt.
Der Parse-Zeiger wird nicht verschoben.
Text to info message
Der Text von der aktuellen Position des Parse-Zeigers bis zum Zeilenende wird in die Info-Meldung kopiert. Ist kein Text vorhanden, wird der Response-Code auf 9 (Text for Info not found) gesetzt und die Ausführung beendet.
Der Parse-Zeiger wird nicht verschoben.
Parsefile Werte und Alarm Limits
Der Parsefile-Job kann in die Wartungszustände Maintenance OK oder Maintenance Major wechseln, abhängig von den übrigen konfigurierten Alarm Limits. Wenn beispielsweise folgendes Alarm Limit konfiguriert ist:
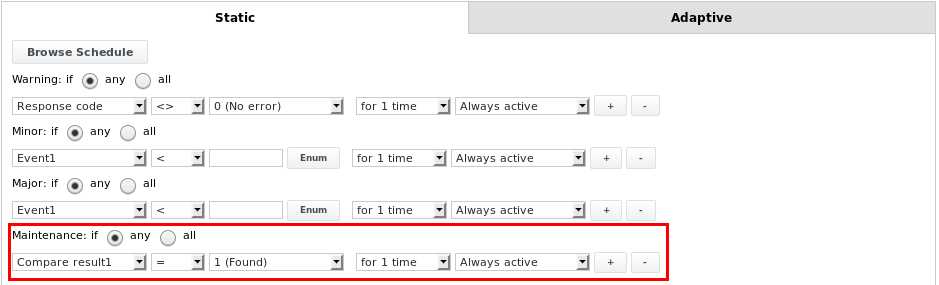
Der Job wechselt in den Zustand Maintenance OK, wenn der Textvergleich einem bestimmten String oder Ausdruck entspricht und sich der Job ansonsten im Zustand OK befindet. Dies kann verwendet werden, um den Job und sein übergeordnetes Gerät (der Wartungszustand wird von einem Job nach oben an sein Gerät weitergegeben) abhängig davon in den Wartungsmodus zu versetzen, was beim Parsen einer Datei mit Informationen zum Wartungszustand (z. B. aus anderen Monitoring-Systemen wie Nagios) gefunden wird. Alle anderen unten aufgeführten Alarm Limits können ebenfalls im Maintenance-Alarm Limit verwendet werden.
Wert / Alarm Limit | Beschreibung |
|---|---|
Event1-X | Prüft, ob basierend auf dem obigen Sequenzparameter Set Event ein Event ausgelöst wurde. |
Return value1-X | Benutzerdefinierter numerischer Wert basierend auf dem obigen Sequenzparameter Get value. |
Rate value1-X | Benutzerdefinierter numerischer Ratenwert basierend auf dem obigen Sequenzparameter Get rate value. |
Diff value1-X | Benutzerdefinierter numerischer Diff-Wert basierend auf dem obigen Sequenzparameter Get diff value. |
String value1-X | Benutzerdefinierter String-Wert basierend auf dem obigen Sequenzparameter Get string value. |
Compare result1-X | Benutzerdefinierter Wert basierend auf dem obigen Sequenzparameter Compare string value. |
Match counter1-X | Benutzerdefinierter Wert basierend auf dem obigen Sequenzparameter Count string matches. |
Response code | 0 No error |
Error code | Generischer Job-Fehlercode (siehe Abschnitt Job error codes) |
Parsefile Beispiele
Beispiel 1 – Parsen einer Datei file.txt mit folgendem Inhalt zum Auslesen der 3 Werte in den letzten 3 Zeilen:
11;OK;33;44.9888;MK;Duration (average): 203.6533s
Open cases:
10
8
1
Die Job-Konfiguration sieht wie folgt aus:
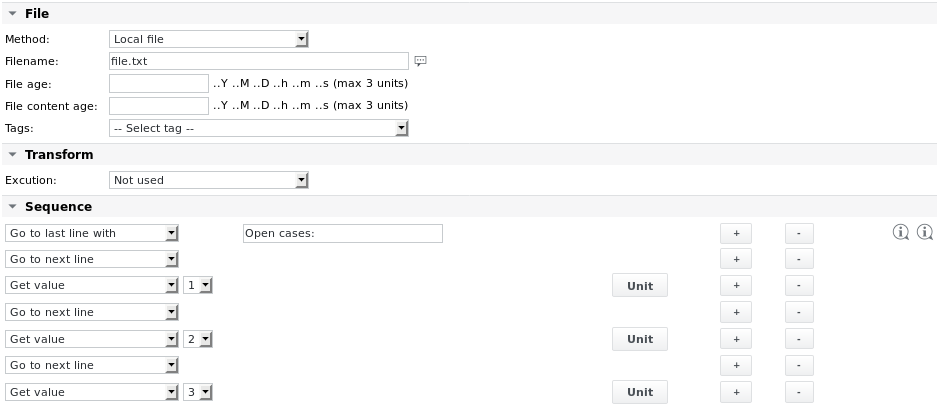
Die Unit-Definition des ersten Get-value-Elements lautet:
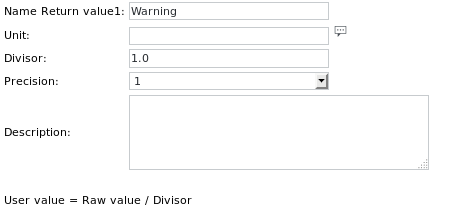
Die anderen beiden Unit-Definitionen sind ähnlich und tragen jeweils die Namen Minor bzw. Major.
Ausgabe 1
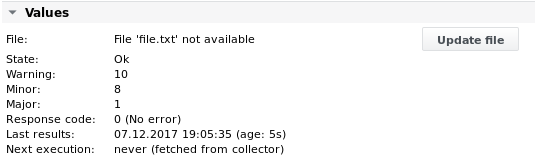
Beispiel 2 – Dieselbe Datei file.txt parsen und Werte spaltenbasiert aus der ersten Zeile extrahieren
Die Enum-Definition des Elements Compare string 1 lautet:
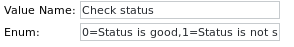
Gesamter Text: 0=Status is good,1=Status is not so good,2=Status is unknown
Die Unit-Definition für Get value 1 lautet:
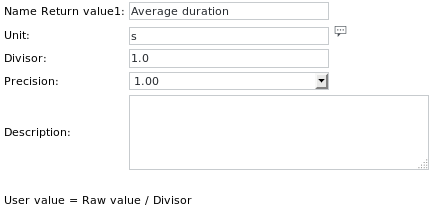
Beachten Sie die erhöhte Precision, um Gleitkommazahlen lesen zu können.
Ausgabe 2
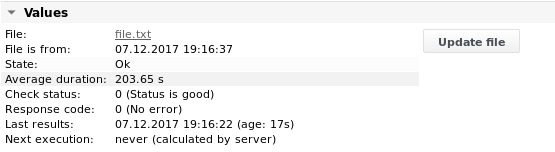
Beispiel 3 – Mithilfe von Variablen-Tags nach einer Zeile suchen, die den Servernamen enthält. In dieser Zeile bleiben und die Werte MeasurementValue1 und CPU_Usage auslesen
Der Dateiinhalt lautet:
Timestamp=Fri Oct 31 09:55:20 CET 2017
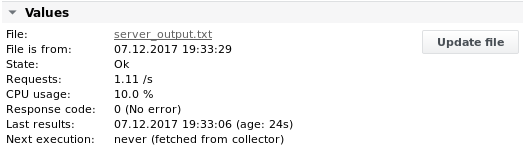
ServerName=myserver01;MeasurementValue1=1.11;CPU_Usage=10%;EnumValue1=OK;
ServerName=myserver02;MeasurementValue1=1.22;CPU_Usage=22%;EnumValue1=BAD;
Der Name des Geräts lautet myserver01.
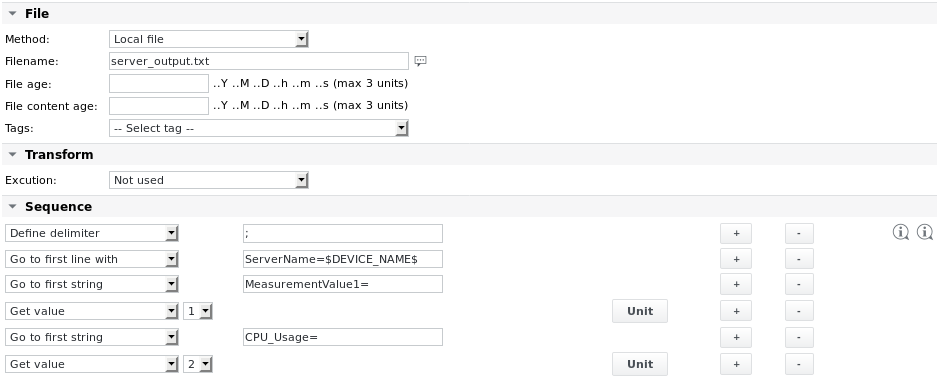
Die Unit-Definitionen lauten:
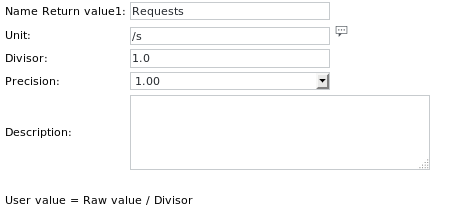
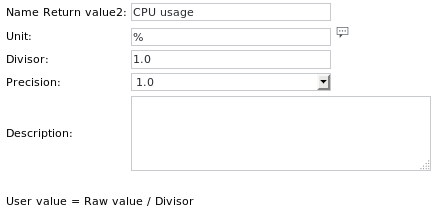
Die Verwendung von SKOOR Engine-Tags ermöglicht es, Jobs auf verschiedene Geräte zu kopieren, sodass sie weiterhin mit dem korrekten Gerätenamen funktionieren.
Ausgabe 3
Beispiel 4 – Zeitstempel aus einer regelmäßig generierten Datei auslesen und Ratenwert ermitteln, um die Anzahl ein- und ausgehender Pakete auf einer Netzwerkschnittstelle zu erhalten
Die Datei wird regelmäßig mit folgendem Inhalt von einem Execute-Job mit dem folgenden Inhalt im Feld Inline script generiert:
date +%s%N | cut -c1-13
netstat -I=eth0
Die erste Zeile gibt den Zeitstempel (Sekunden seit dem 1.1.1970) in ms-Genauigkeit aus, die zweite Zeile gibt die Empfangs-/Sendestatistik auf der Netzwerkschnittstelle eth0 aus. Die generierte Datei lautet:
1512726065120
Kernel Interface table
Iface       MTU Met    RX-OK RX-ERR RX-DRP RX-OVR    TX-OK TX-ERR TX-DRP TX-OVR Flg
eth0       1500   0  5761332      0      0      0  2932100      0      0      0 BMRU
Die Ratenwerte (ein- und ausgehende Pakete) sind unabhängig von den Ausführungsintervallen sowohl des Execute-Jobs als auch des Parsefile-Jobs. Üblicherweise ordnet man den Execute-Job und den Parse-Job unter einem Batch-Job an und weist ihnen das Ausführungsintervall No repetition zu, sodass nur der Batch-Job ein Ausführungsintervall besitzt.
Der Parsefile-Job sieht wie folgt aus:
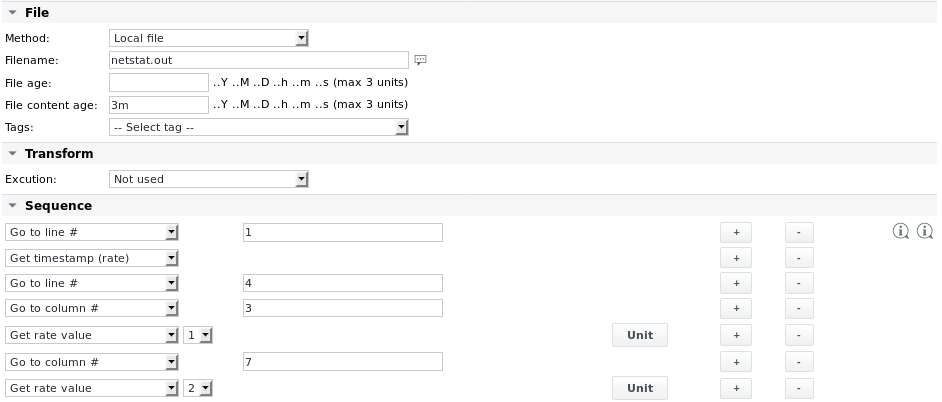
Die Unit-Definitionen lauten:
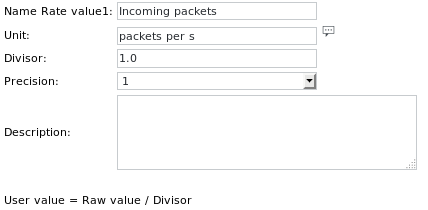
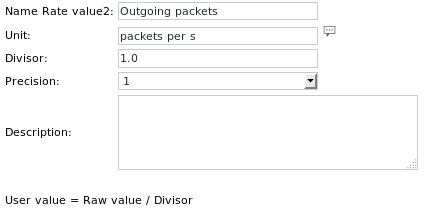
Ausgabe 4
Die Werte werden nach der zweiten Ausführung des Jobs ausgegeben (der Ratenwert erfordert einen Vergleich mit der vorherigen Messung):
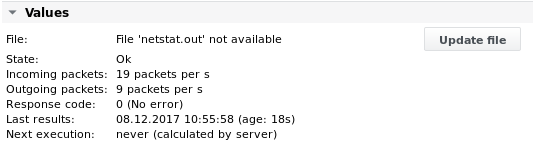
Beispiel 5 – Events aus geparstem Inhalt generieren
Eine durch einen externen Job generierte Datei einlesen und nach bestimmten Strings suchen. Event1 generieren, wenn der String Error gefunden wird. Das Event nach einer bestimmten Zeit zurücksetzen. Außerdem Event2 generieren, wenn der String Process mysqld terminated gefunden wird. Das zweite Event nur zurücksetzen, wenn weiter unten in der Datei oder bei der nächsten Job-Ausführung der String Process mysqld started gefunden wird.
In diesem Beispiel setzt das erste Element in der Parse-Sequenz den Parameter Syslog mode. Dadurch wird sichergestellt, dass nur neue Daten in der Datei geparst werden. Die älteren Teile der Datei, die bei der letzten Job-Ausführung geparst wurden, werden bei nachfolgenden Job-Ausführungen nicht mehr berücksichtigt. Findet der erste Job-Lauf den String Error in der Datei, setzt er Event1. Werden während der nächsten 10 Job-Ausführungen (das Job-Intervall ist auf 1 Minute eingestellt) keine neuen Error-Strings gefunden, wird das Event zurückgesetzt.
Der Event-Mechanismus ermöglicht es dem Job, nach einer bestimmten Zeit in einen OK-Zustand zurückzukehren, während gleichzeitig die Möglichkeit besteht, eine Alarm-E-Mail auszulösen, wenn ein Event gesetzt wird.
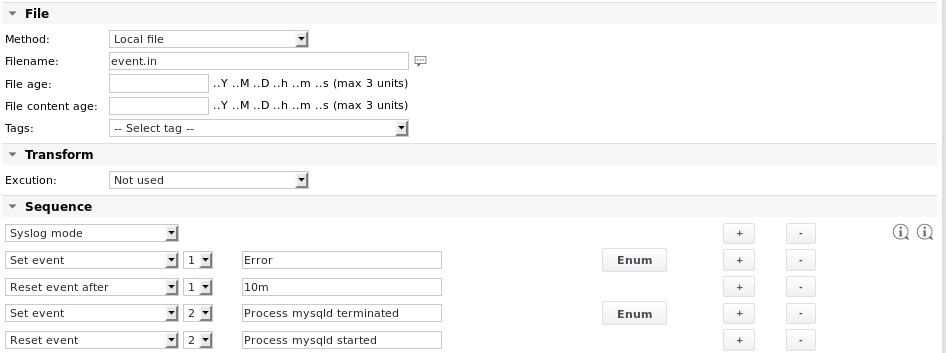
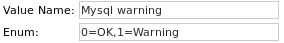
Die Enum-Definitionen lauten:
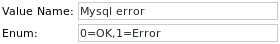
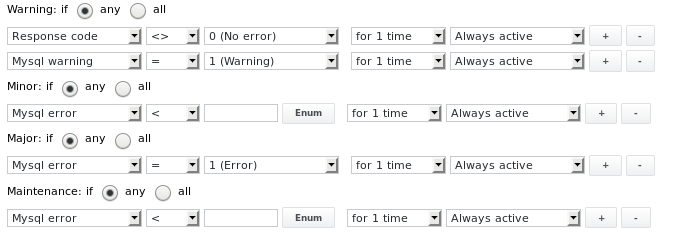
Die Alarm Limits sind wie folgt konfiguriert:
Ausgabe 5